注意力机制#
通过引入同一序列计算得出的 Query/Key/Value 来改进上下文向量的计算公式,从而 “避免 RNN 中编(解)码器的串行隐状态计算”。
eijci=α(si−1,hj)=j=1∑Taijhj→aij=α(qi−1,kj)→yi=j=1∑Taijvj
通过评分函数 α 计算 “查询” 对每一个 “键” 的相似度得到权重矩阵,然后与 “值” 聚合起来得到上下文向量。
用查字典来举例:查询的信息为 “中国”,计算对字典中每个词的相似度得到相似度最大的两个词 “华夏”、“唐宋”。然后将这两个词对应的信息聚合起来,来代表 “中国” 这个词。
推荐查看 - https://jalammar.github.io/illustrated-transformer/ ↗
缩放点积注意力#
自注意力(Self-Attention)通过 “计算同一段序列中不同词元之间的注意力”,从而对序列中的每一个词元进行上下文建模。
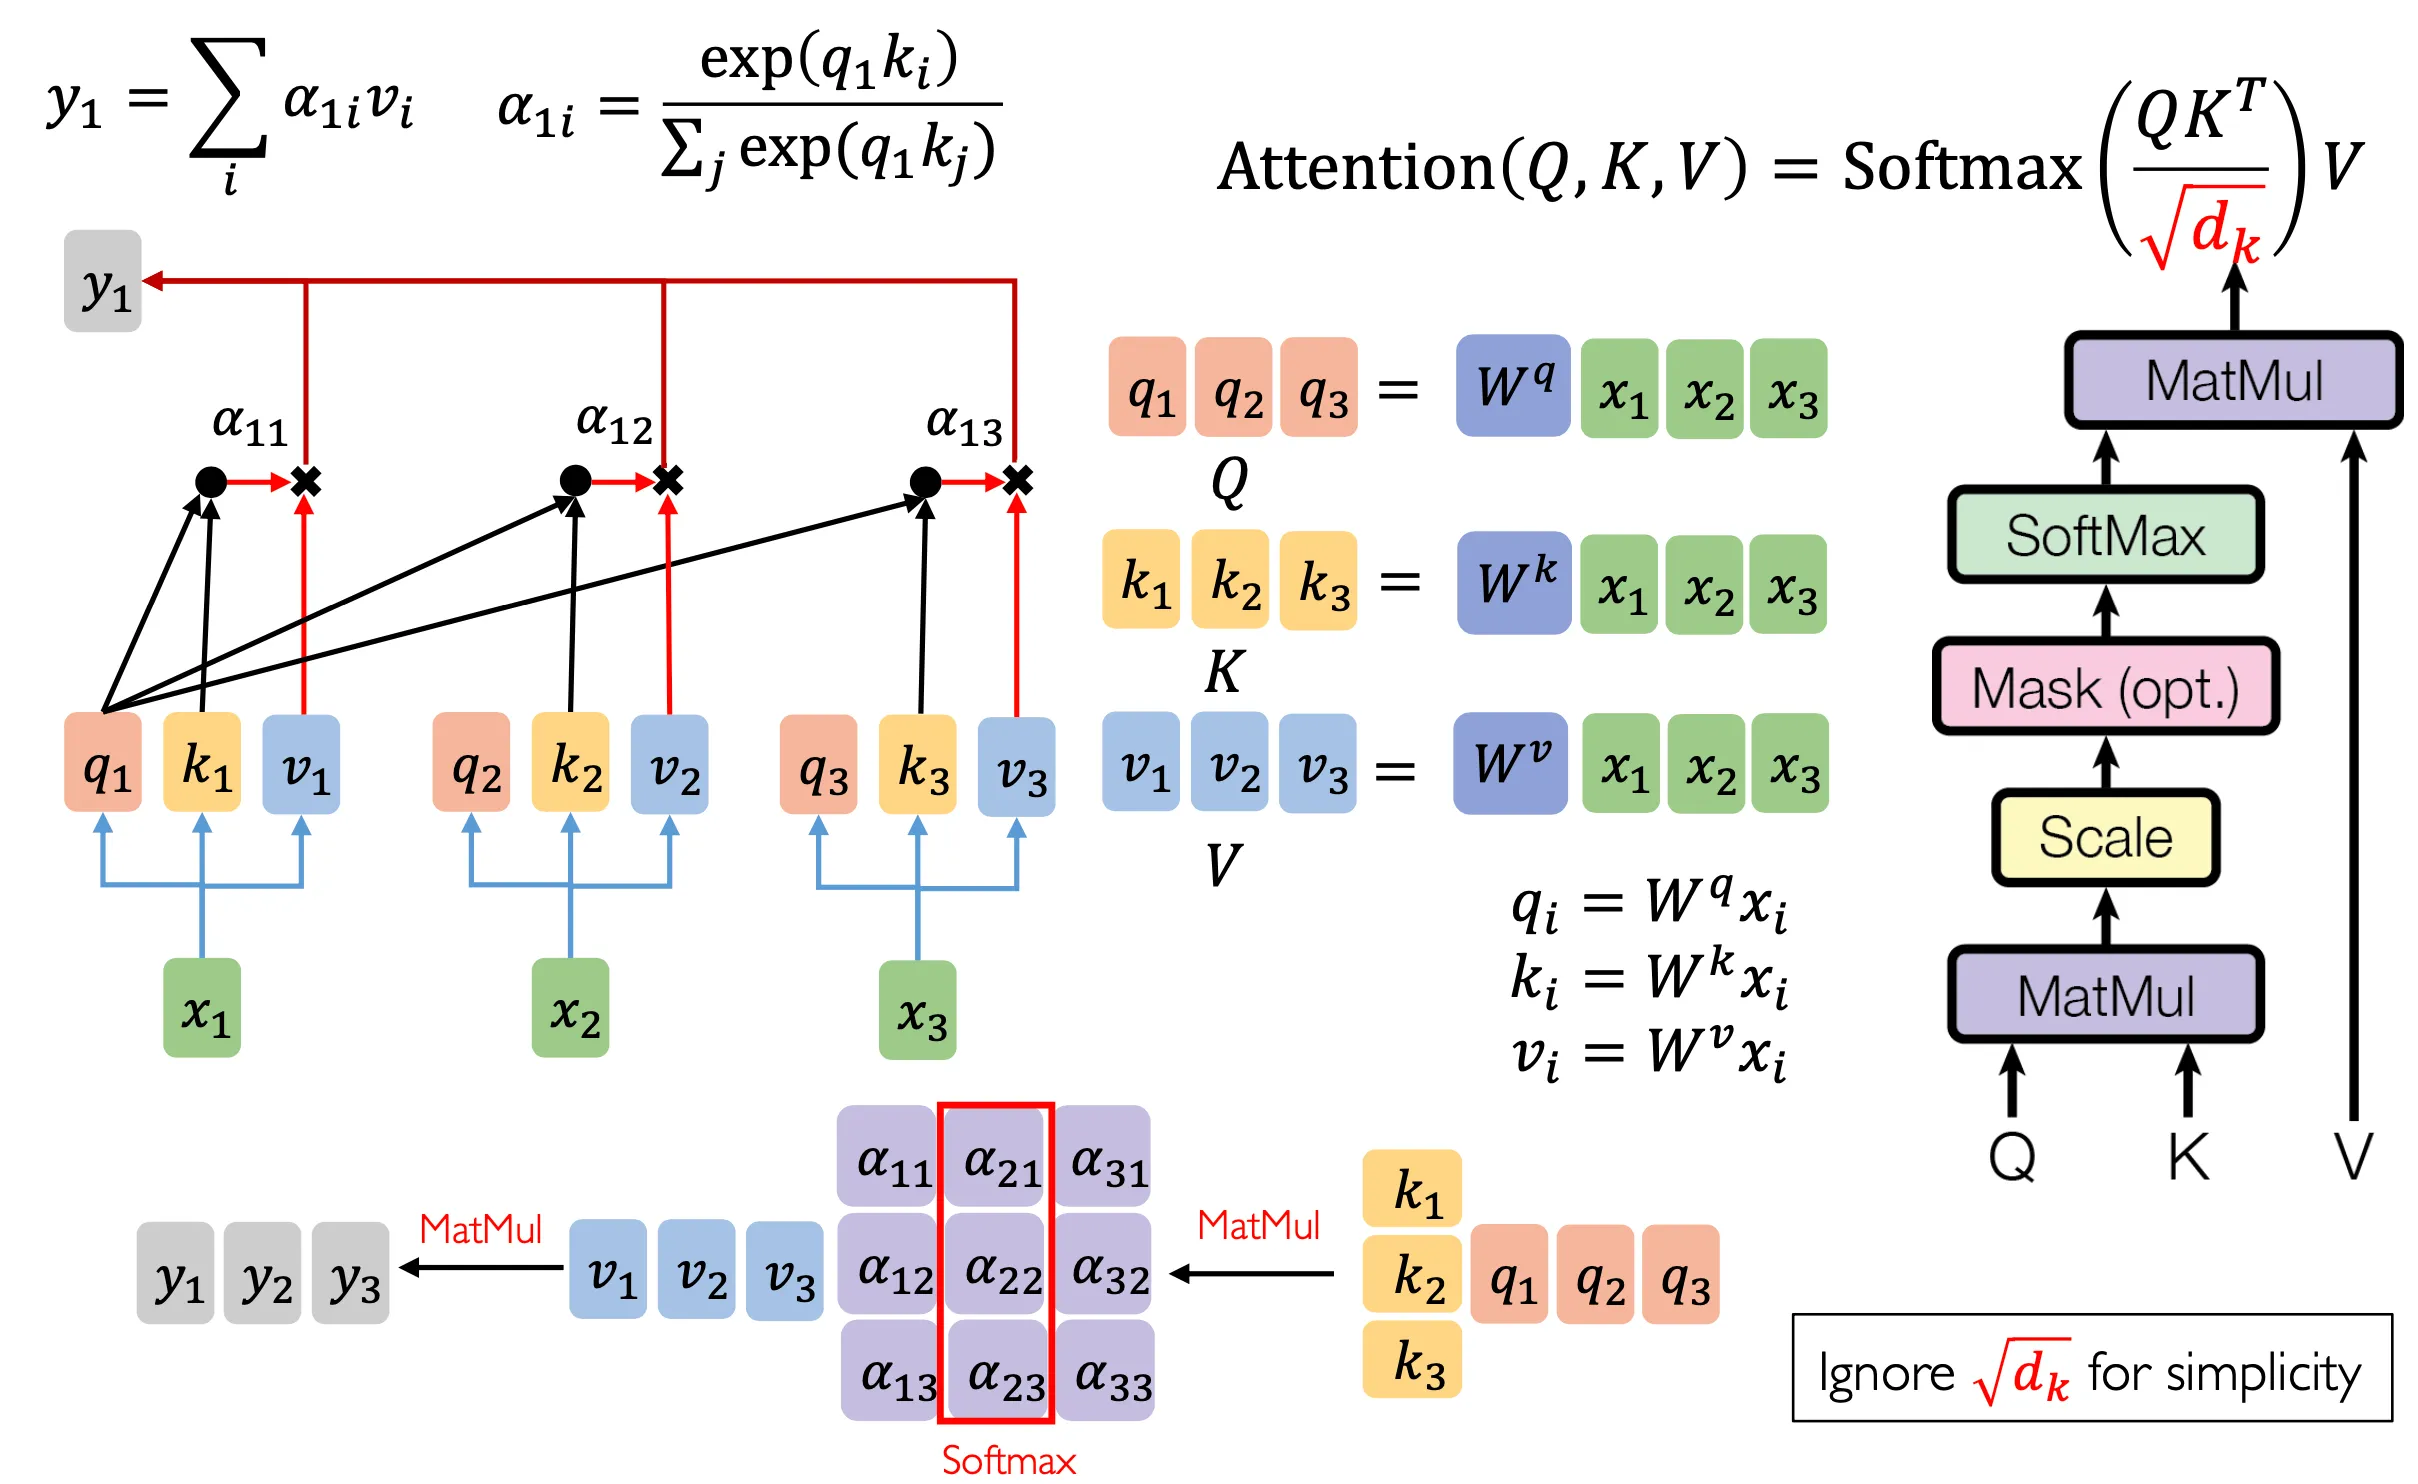
第一个词元的查询向量 q1 与所有词元的键向量 k1,2,3 之间计算相似度得到 a11,12,13 权重向量,然后权重向量与所有的值向量 v1,2,3 进行矩阵相乘得到第一个词元的上下文向量 y1,该向量聚合了其余词元对当前词元的影响程度。以此类推就可以得到每一个词元的上下文向量,从而建模所有词元之间的关系依赖。
多头注意力#
单头无法表征序列的所有信息,通过引入不同的头在 “同一时刻关注序列中的不同部分”,从而学习到不同的上下文向量,汇总之后作为逐词元的上下文向量。
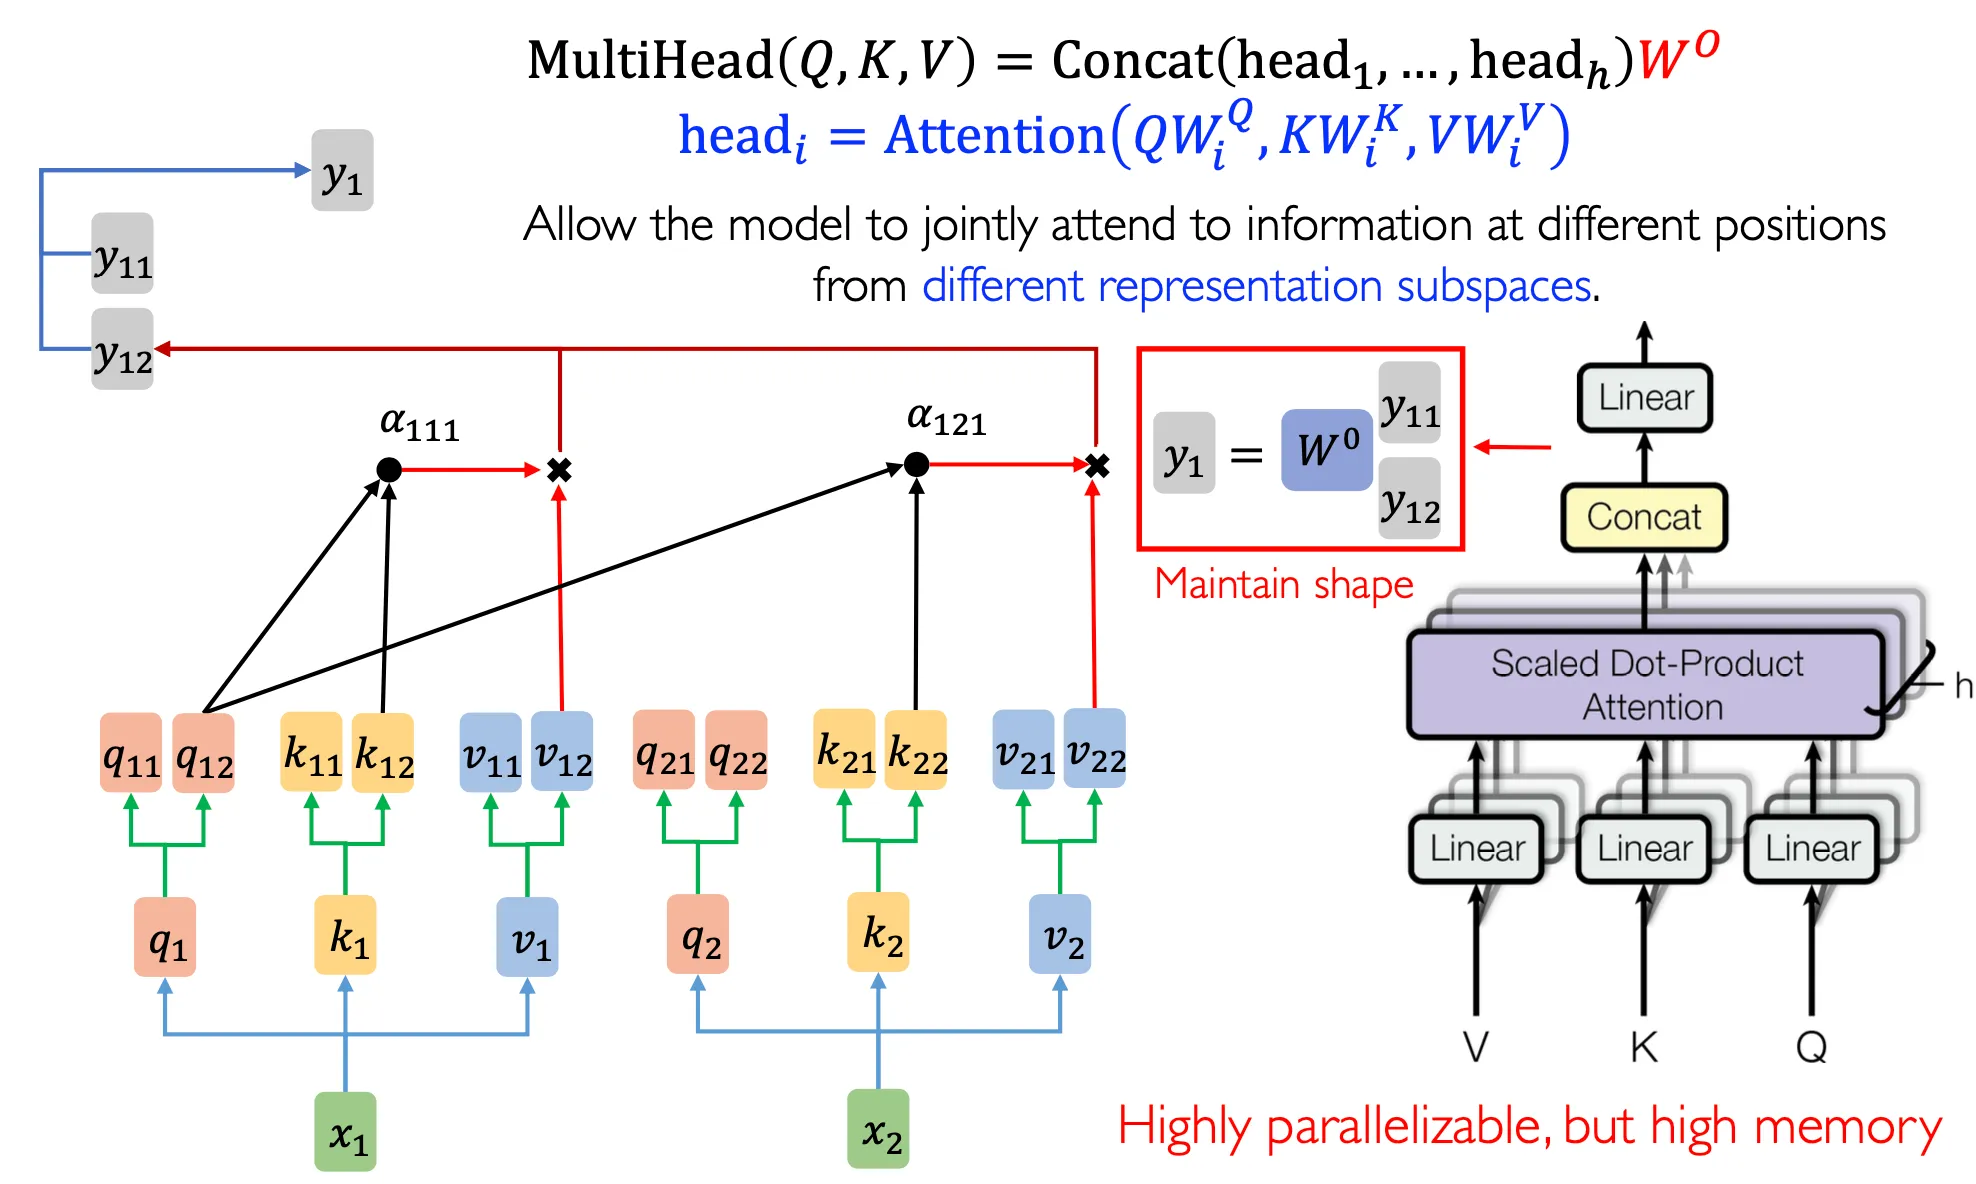
(每个头独立计算) 以第二个头的计算举例,第一个词元的切分查询向量 q12 与所有词元的切分键向量 k12,22 之间计算相似度得到 a112,122 切分权重向量,然后与所有切分值向量 v12,22 进行矩阵相乘得到第一个词元的切分上下文向量 y12。此时第一个头的并行计算结果为 y11,将其汇总之后得到第一个词元的上下文向量 y1。以此类推得到每个头为每个词元计算的切分向量,汇总之后注入更多信息。
参数维度分析 - 假设 d 是词向量维度、nh 是注意力头的数量、dh 是每个头的维度、s 是序列长度:
- 输入为 X∈Rd×s、权重参数为 Wq∈Rdhnh×d,那么查询矩阵为 Q∈Rdhnh×s;
- 结合查询矩阵和键矩阵得出权重矩阵为 A∈Rs×s,且值矩阵为 V∈Rdhnh×s;
- 结合权重矩阵和值矩阵得出上下文矩阵 Y∈Rdhnh×s,每一个上下文向量为 y∈Rdhnh×1;
- 结合后续的输出矩阵 Wo∈Rd×dhnh 得到最终的注意力层输出为 O∈Rd×s。
可以发现 “注意力层的输入和输出维度是相同的”。
逐位前馈神经网络#
将注意力层输出的特征进一步进行非线性变换从而进一步提升模型的表达能力。逐位指的是 “每个词元的特征重计算都是独立的”。
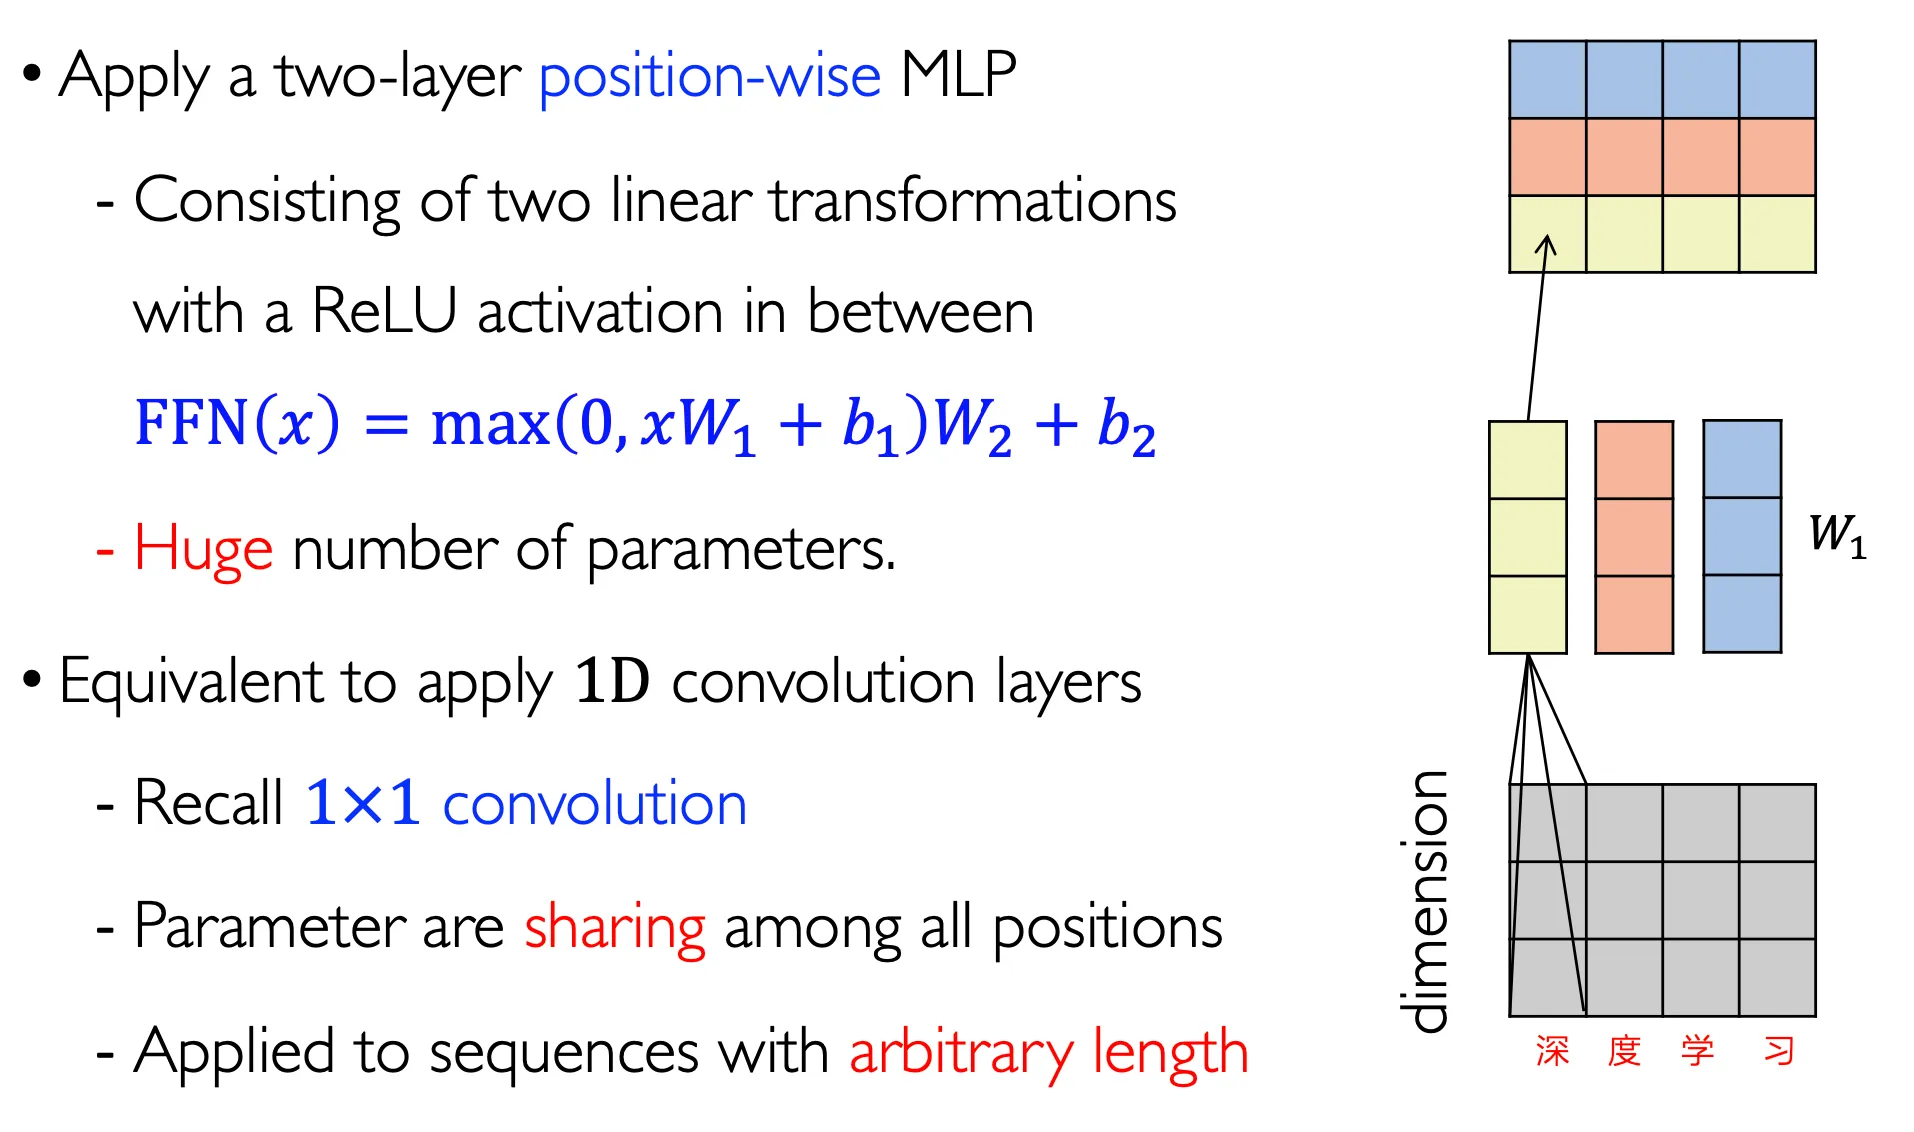
上图右侧展示的是一次非线性变化的结果,并且可以使用 1×1 卷积替代非线性变换操作。
绝对位置编码#
自注意力机制具有 “置换不变形”,无法捕捉序列中的顺序关系,因此引入位置编码对序列进行位置建模。
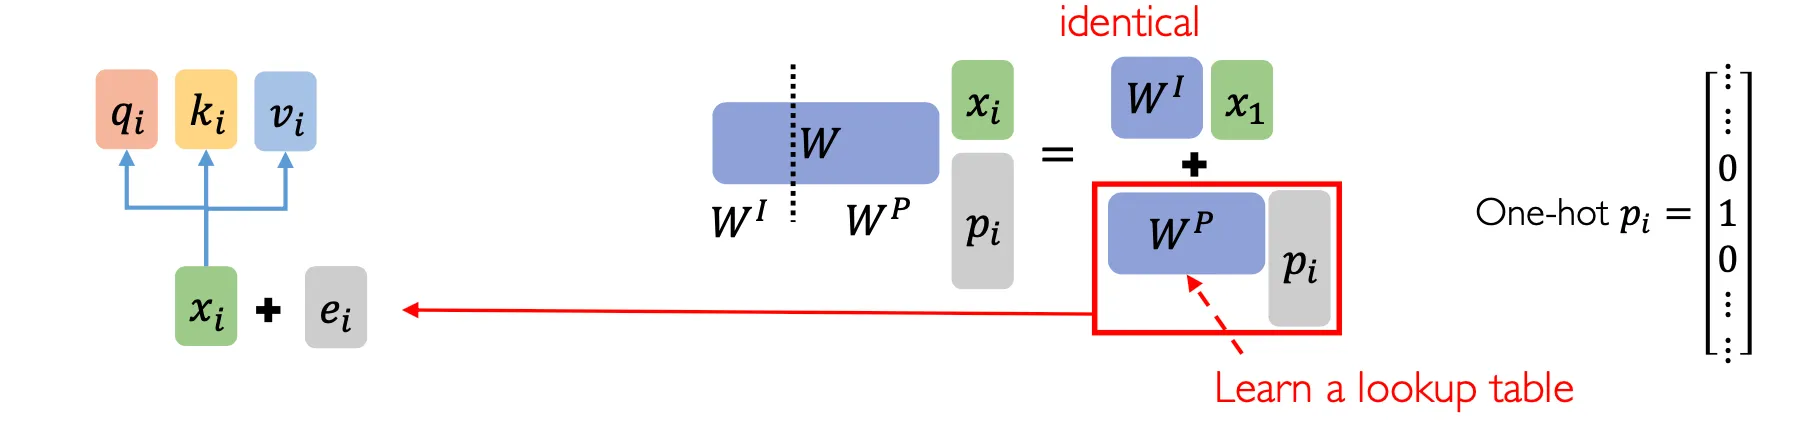
根据 “正余弦函数” 来生成 “对应位置的唯一位置嵌入”,并将其加到词元的词向量上。对于维度大小为 d 的词向量,它的编码方式为:
{pk,2i=sin(k/100002i/d)pk,2i+1=cos(k/100002i/d)
其中 pk,2i 和 pk,2i+1 表示第 k 个词元的词向量的 2i 和 2i+1 个分量。
激活函数#
GeLU(Gaussian Error Linear Unit)利用基于正态的累积分布函数来调节输入信息的激活程度,使得中间区域的输入梯度更为平滑,起到正则化的作用。
GeLU(x)=x⋅Φ(x)=x⋅21(1+erf(2x))
其中 Φ(x) 是累积分布函数、erf(⋅) 表示误差函数。
SwiGLU(Swish-Gated Linear Unit)将 Swish 的平滑与 GLU 的门控机制结合起来使得梯度能够有效传播,是目前 LLM 使用的主流激活函数。
SwiGLU(x)=Swish(xW1+b1)⊗σ(xW2+b2)
编码器 / 解码器#
Transformer 堆叠了六层编(解)码器,并且 “每层输入和输出的维度都是 (batch, seq, hidden)“,即批量大小、序列长度、词向量维度。
解码器在推理阶段具有 自回归属性,具体来说:1)输入经过解码器后获得词表上的概率分布并采样得到输出;2)将输出添加到下一步输入后侧并继续生成。
而在训练阶段因为提供了目标序列,使得模型能够参考该序列直接获得下一个词元。而通过 “掩码多头注意力” 对权重矩阵进行下三角遮掩,就能使得模型在训练阶段 “只参考历史信息而忽略未来信息”。
aij={0−∞j≤ij>i→未来词元
通过对注意力权重进行遮掩,使未来词元对应的分数在随后进行 softmax 时趋近于 0,从而在计算上下文向量时屏蔽未来词元的影响,进而保持解码器训练阶段的自回归属性。
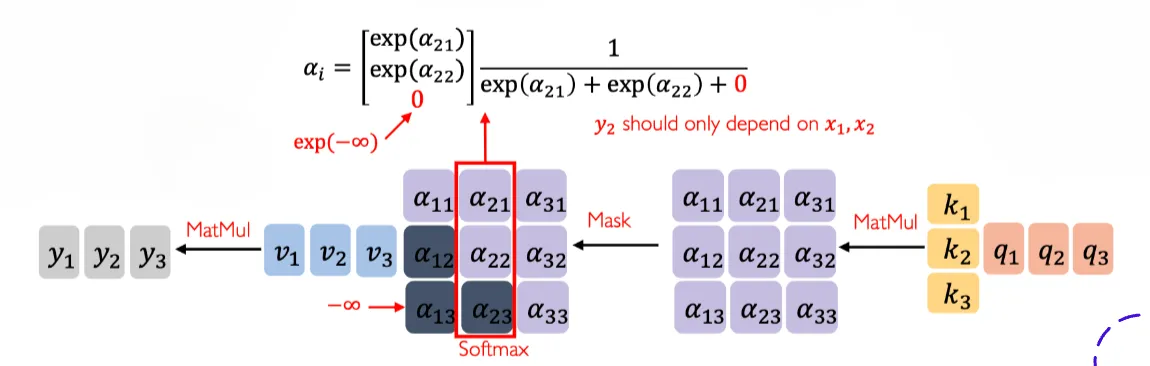
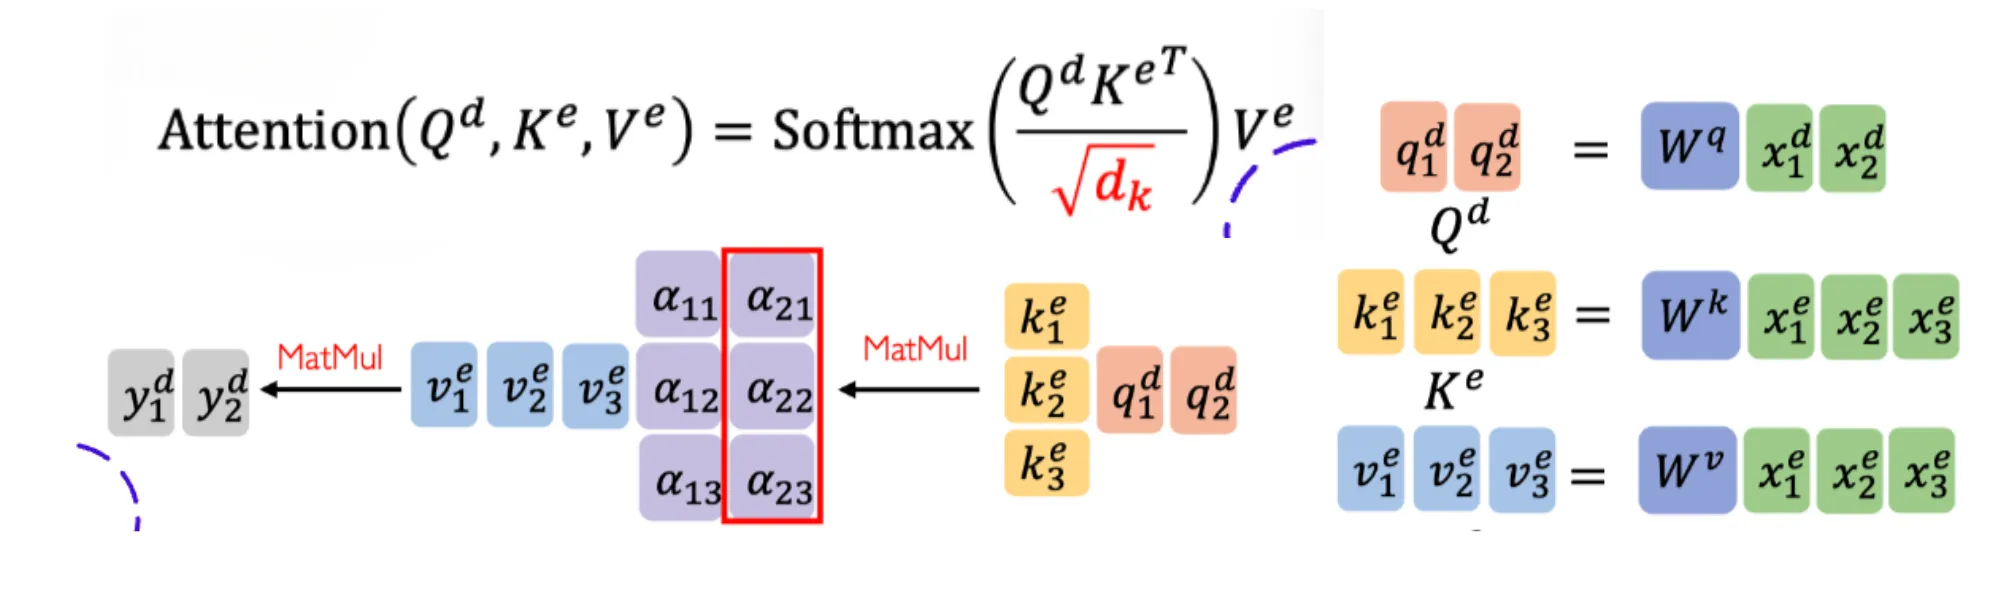
通过 “交叉注意力(Cross Attention)” 机制来处理编码器最后一层的 K/V 和解码器当前层的 Q。
注意力模块的优化#
自注意力模块中的权重矩阵计算是二次复杂度 O(n2),因为它要对序列中的任意两个词向量计算相似度。
Sparse Attention#
从注意力分数矩阵的角度来说,就是除了相对距离不超过 k 的、相对距离为 k 的倍数的注意力权重都设置为 0。这样注意力就具有了 “局部紧密相关和远程稀疏相关” 的特性。
该方法的不足之处就是需要人工选择保留的注意力区域,不利于扩展。但是由于将每个词元的注意力压缩在了较小的空间中(每个词元只能看到训练长度的词元),因此能 “一定程度上缓解长度外推问题”。
Linear Attention#
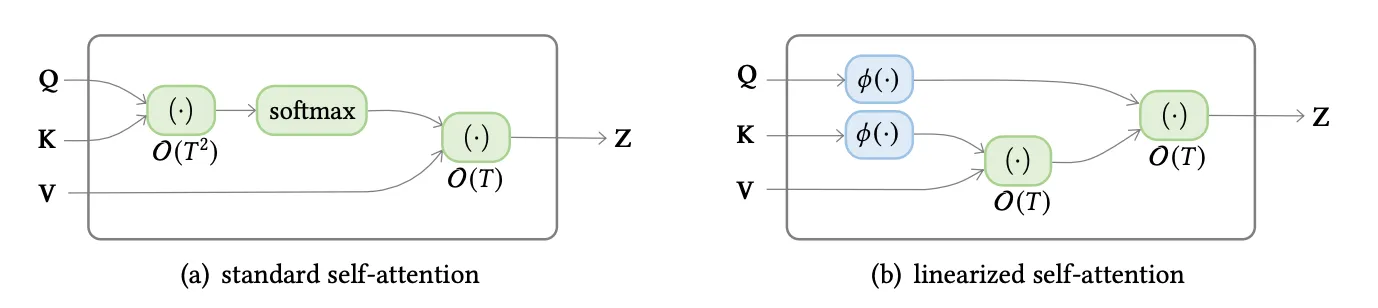
通过观察上图可以发现如果去掉 softmax 函数和缩放系数,那么注意力的计算实际上就是三个矩阵连乘,复杂度仅有 O(s)。因此用一般函数 sim(⋅) 替代指数操作:
attn(qi,kj,vj)=∑j′=1nsim(qi,kj′)∑j=1nsim(qi,kj)vj
为了保留注意力相似的分布特征,我们需要保证 sim(qi,kj)≥0 恒成立。
而线形注意力就是用 “核函数” 代表这个一般函数,即 sim(qi,kj)=ϕ(qi)Tϕ(kj)。
attn(qi,kj,vj)=ϕ(qi)⋅[ϕ(kj)Tvj]
其中核函数选择 ϕ(x)=elu(x)+1。
KV Cache#
自回归属性的解码器在 “Token-by-Token” 生成时每一次上下文向量的计算都涉及当前时刻的 “查询” 和历史时刻的 “键/值”。而 KV Cache 通过 “缓存并重用历史的键/值”,从而提升推理速度。
假设解码器的层数为 l,那么每生成一个词元就需要保存 2nhdhl 个元素,可以发现缓存的大小 “随着序列长度的增加呈现线形增长”。但是缓存的内容都保存在 “HBM” 中,因此容易导致读写/存储带宽瓶颈。
后续针对注意力机制的改进都是围绕如何在减少缓存的同时能够实现在更少设备上推理更长的上下文,或者在相同推理上下文的背景下使用更大的批量,从而实现更快的推理速度 / 更大的吞吐总量。
GQA / MQA / MLA#
GQA 将注意力头切分为 g 组,每组共享同一个键/值,若原来是 nh 个头,那么每 gnh 个头共享一份键/值。而 MQA 在所有头中共享一份键/值。可以发现当 g=1 时 GQA 就会退化为 MQA。
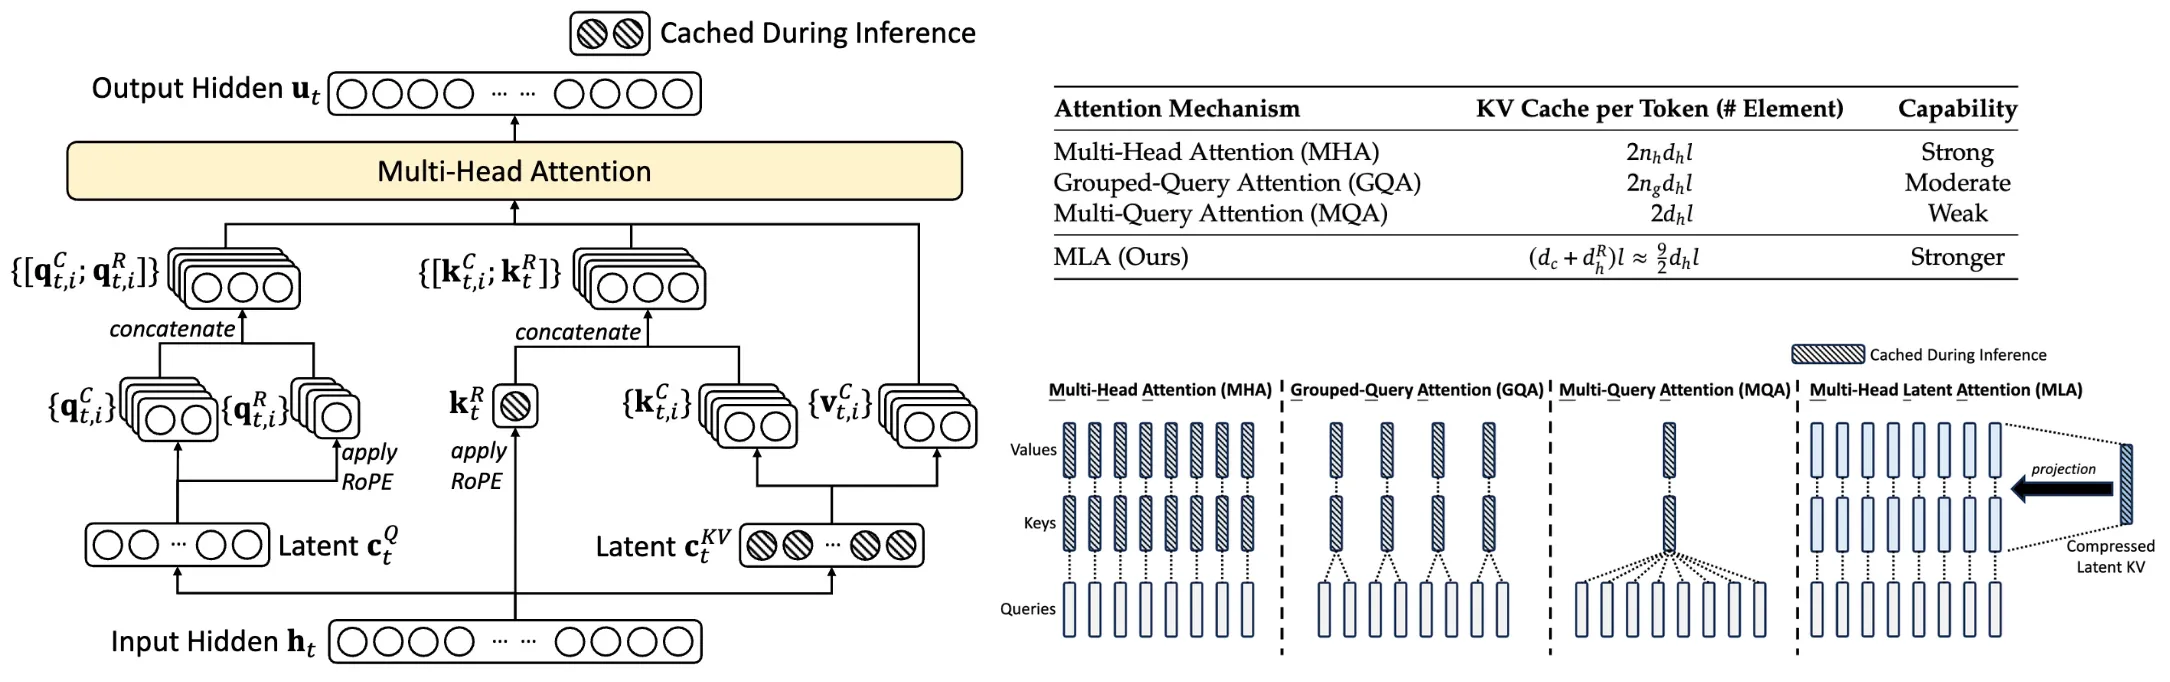
Multi-Head Latent Attention(MLA) 的核心思想是 “低秩键值联合压缩 / 解耦 RoPE”:
-
通过缓存压缩的潜在向量 ctKV 从而避免在每次生成时重复计算高维的 “键/值向量”:
score(qtC,ktC)=(qtC)T×ktC=(WUQctQ)T×(WUKctKV)=(ctQ)T(WUQ)T×(WUK)(ctKV)=(ctQ)T上投影矩阵权重融合[(WUQ)T×(WUK)](ctKV)←基于对应的潜在向量ct←基于矩阵转置性质←基于乘法结合律进行权重融合
若不采用 “权重融合” 且假设推理阶段生成 n 个新词元,那么就需要进行 n−1 次矩阵向量乘法,这无疑是非常低效的。同理也可以将 WUV 融合到 WO 中。
-
解耦(Decoupled) RoPE 将 “查询/键” 向量切分为内容部分(携带语义信息)和位置部分(携带位置信息):
qtRqtotut=RoPE(WQRctQ)ktR=RoPE(WKRht)=[qtC;qtR]=j=1∑tsoftmaxj(dh+dhRqtTkj)vjC=WOot←解耦键向量共享←注入位置信息←使用拼接后的向量计算注意力←计算汇总后的上下文向量
通过对新的位置部分 ktR 进行 RoPE 然后将信息拼接注入到内容部分上,从而避免了对 “查询/键” 向量旋转产生的带有位置信息的矩阵 Rn−m 而无法进行 “权重融合” 的现象。
在实际的推理过程中,我们只需要缓存低维潜在向量 ctKV∈Rdc (dc≪dhnh) 以及解耦出的低维位置键向量 ktR∈RdhR 即可,分别用来计算上下文向量和位置信息。此时每个词元的缓存元素大小为 (dc+dhR)l。
Flash Attention#
注意力计算过程中最大中间结果就是分数矩阵,而最终的上下文向量反而很小。Flash Attention 通过将中间计算结果保留在大带宽的 SRAM 中,获得最终结果再写回小带宽的 HBM 中的操作,避免了带宽瓶颈。
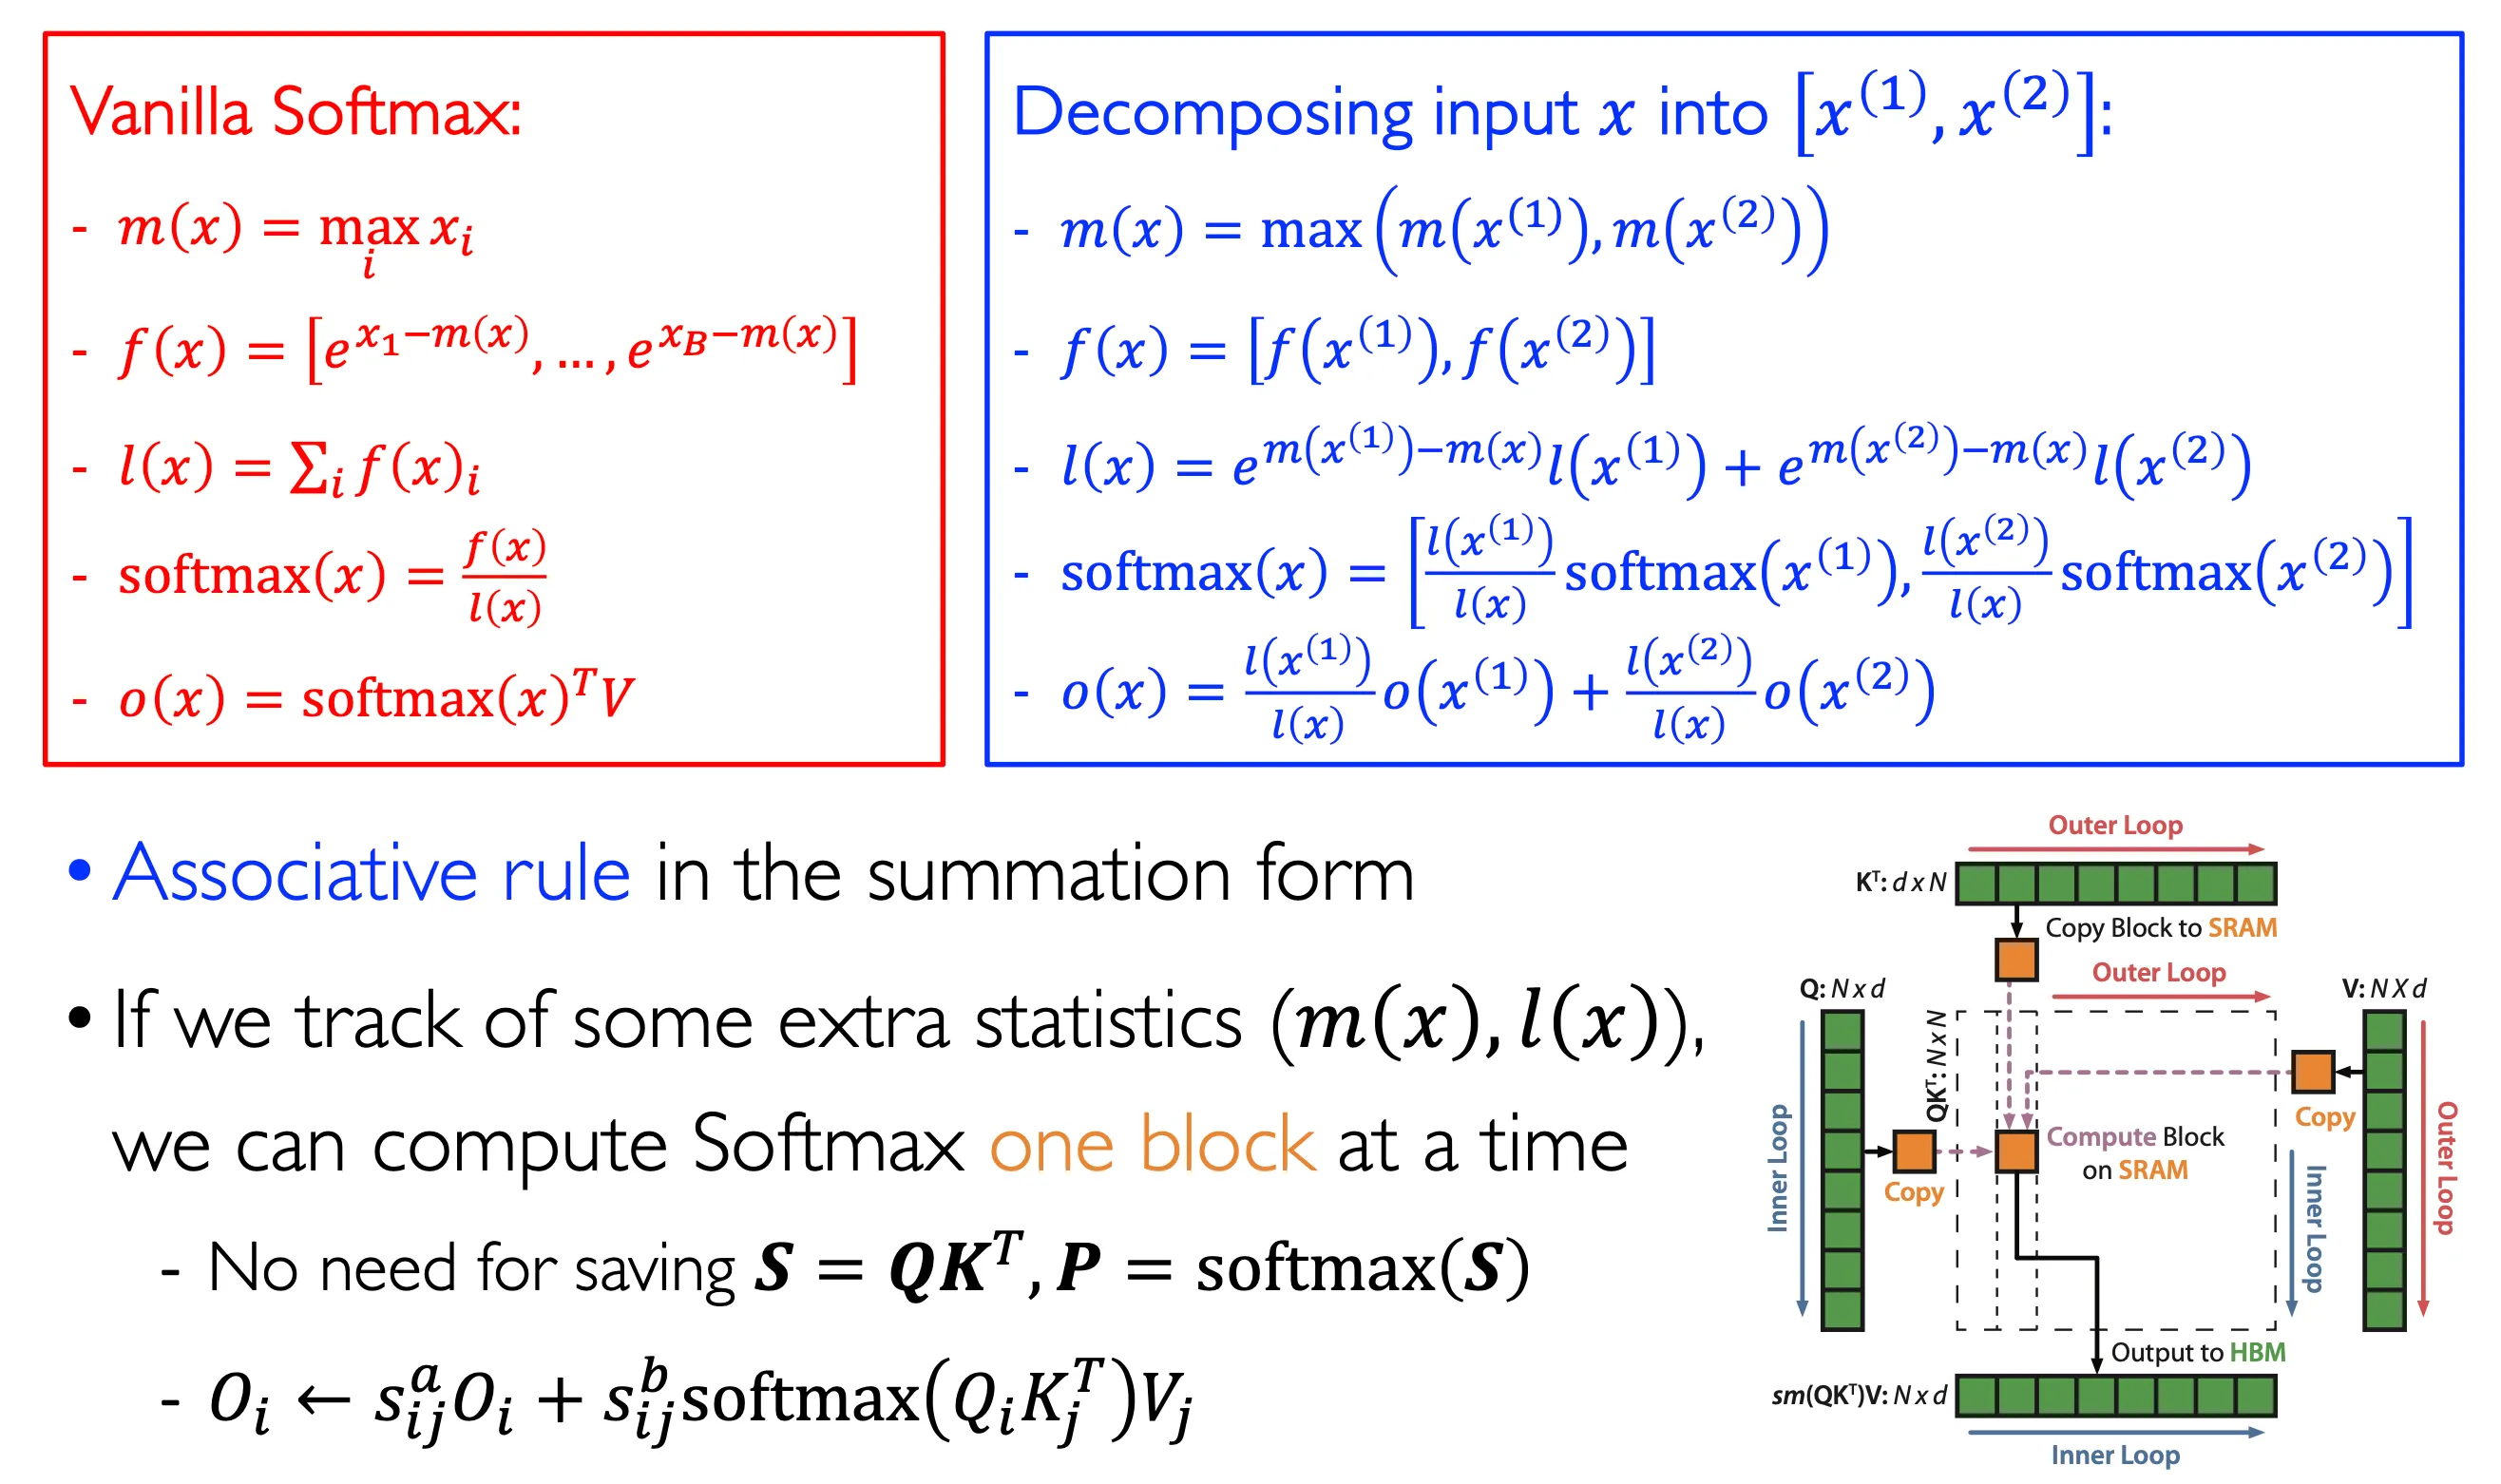
具体来说,其将所有的注意力计算操作融合(Fuse)到一个单独的 GPU 内核中,在这个融合内核中,包括 分块计算(Tiling) 和 重计算(Recomputation) 两项技术。最终的 HBM IO 复杂度对比:
- Vanilla Attention - O(nd+n2);
- Flash Attention - O(n2d2/m)≪O(nd+n2)。
Ring Attention#
混合专家模型(MoE)#
MoE 将原来 Transformer 等架构中的 FFN 层替换为一个包含 “多路专家子网络” 的稀疏模块,每个专家在训练阶段根据输入数据动态学习不同的特征,而在推理阶段只调用最相关的若干个专家,从而达到提高模型表达能力同时节省计算资源的目的。
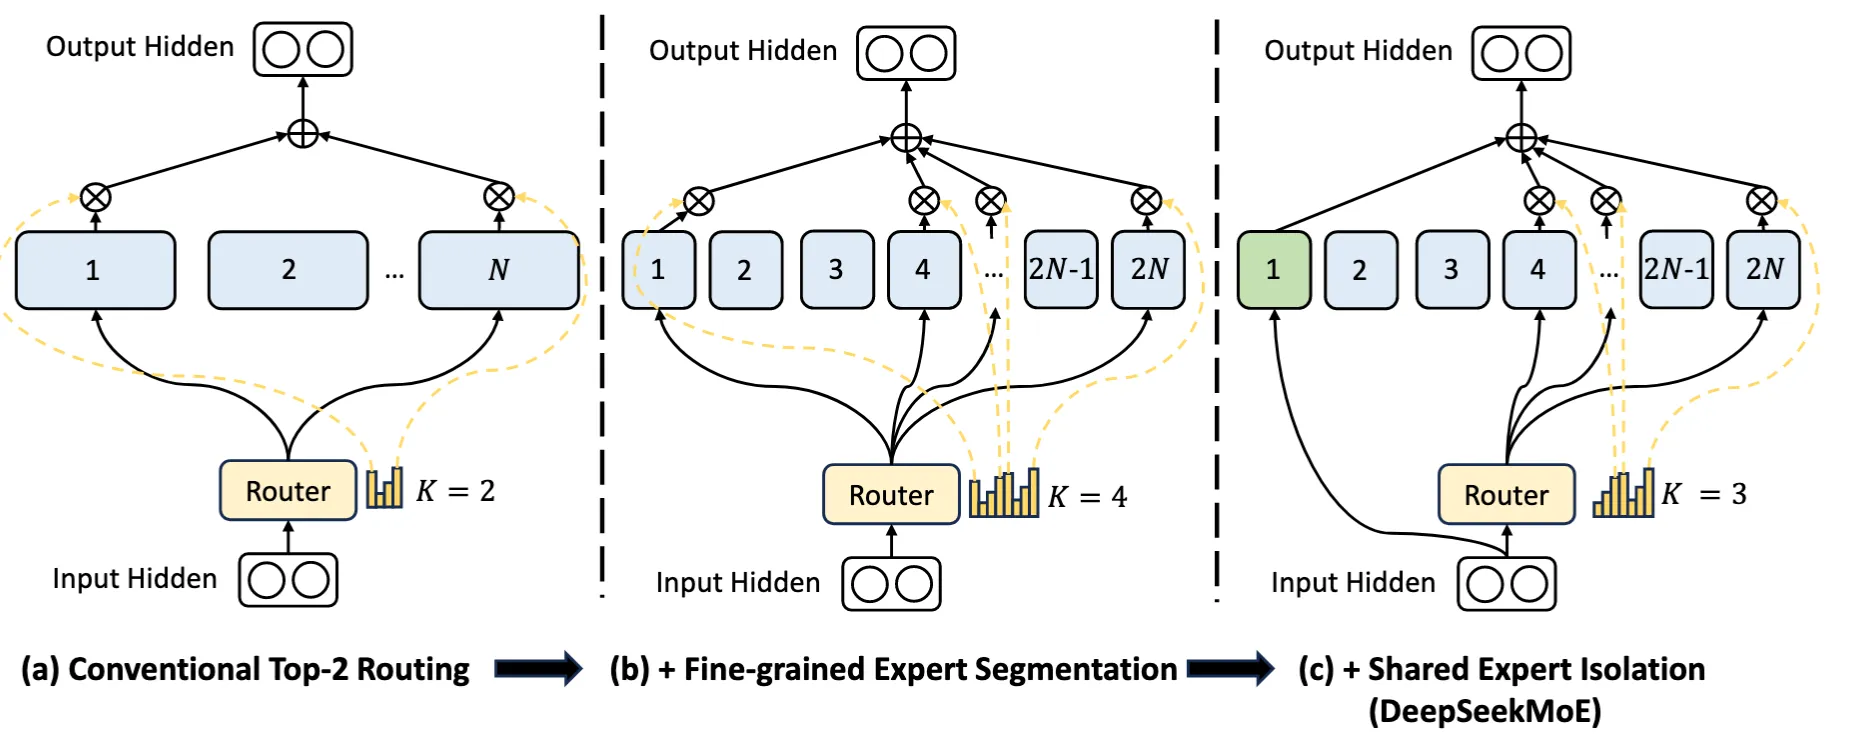
首先通过 “门控网络(Router)” 计算权重,该权重表示每个专家对当前词元的关注程度。通常是一个简单的神经网络,将输入隐状态 htl 通过 softmax 映射为概率分布:
si,t=softmaxi(htlwil)
其中 wil 表示第 l 层第 i 个专家的权重、si,t 表示第 i 个专家对第 t 个词元的关注程度(亲和度分数)。然后取 top-k 个专家参与计算,其余权重置零(稀疏激活),最后将专家权重/输出聚合。
otl=i=1∑N[gi,t×FFNi(htl)]+htl
传统的 MoE 存在以下问题:1)单个专家涵盖多种知识,无法充分同时利用;2)多个专家涵盖通用的冗余知识,阻碍了 MoE 的理论性能上限。
DeepSeekMoE 通过 “划分更细粒度的专家” 以及 “单个专家存储通用知识” 来解决上述问题,从而实现每个专家的高度专业化:
otlgi,t=i=1∑ksFFNi(htl)+i=ks+1∑mN(gi,t×FFNi(htl))+htl={si,t0si,t∈topk({sj,t∣ks+1≤j≤mN},mk−ks)otherwise
将专家的中间维度缩小 1/m 倍并将数量提升 m 倍。隔离 ks 个专家作为共享专家并时刻保持激活,而其它路由的专家数量就要相应减少 ks 个,因此在保持计算成本和参数量的前提下激活的专家数量为 mk−ks。
归一化#
Post / Pre-Norm#
Post-Norm - 归一化放置在残差计算之后:
Post-Norm(x)=Norm(x+Sublayer(x))
训练时间较快、网络容易调优、输出层梯度较大引发的训练不稳定。
Pre-Norm - 归一化放置在子层计算中:
Pre-Norm(x)=x+Sublayer(Norm(x))
训练稳定、效果不如 Post-Norm、缓解梯度消失(爆炸)问题,现代 LLM 首选。
RMS-Norm#
在 Layer-Norm 中减去均值表示将数据分布的中心移动到原点(重中心化)、除以标准差表示将数据分布调整为标准大小(重缩放)。其成功的关键在于重缩放带来的方差不变性,而重中心化贡献较小且在某些情况下会损失性能。
RMS-Norm 通过去除重中心化,保留重缩放从而在保证性能的情况下降低计算复杂度。
h^t=RMS(ht)ht⊙γ,RMS(ht)=d1i=1∑dhi2
位置编码#
绝对位置编码#
输入由词向量 Exi 和位置向量 Ui 组成,对注意力分数计算公式 qiTkj 进行因式分解得到:
Ai,jabs=内容相关项ExiTWqTWkExj+内容-位置耦合项ExiTWqTWkUj+位置-内容耦合项UiTWqTWkExj+位置相关项UiTWqTWkUj
可以发现只有最后一项包含 Ui 和 Uj,理论上包含相对位置 (j−i) 的信息,但因为 Wq 和 Wk 的非线形变换,导致相对位置信息被破坏了。
相对位置编码#
Ai,jrel=ExiTWqTWk,EExj+ExiTWqTWk,RRi−j+uTWk,EExj+vTWk,RRi−j
其中 R 为相对位置编码矩阵、u 和 v 都是所有层共享的可学习参数。并且由于 Ri−j 的编码空间与输入空间 E 不一定相同,所以将 Wk 矩阵替换为了 Wk,E 和 Wk,R。
T5 位置编码#
如果认为输入信息和位置信息是应该独立/解耦的,那么内容-位置耦合项和位置-内容耦合项应该被移除,并且加上一个可训练的偏置项:
Ai,jrel=ExiTWqTWk,EExj+ri−j
其中可学习参数 r 在所有层都是共享的,并且不同的注意力头使用不同的位置编码。
ALiBi#
该方式具有优秀的长度外推能力,其注意力分数计算公式为:
qiTkj−λ(i−j)λ=2(−8i/k)
其中 i−j 是 Q/K 之间的位置偏移、λ 是每个注意力头 k 的惩罚系数。位置偏移越大惩罚就越大。
RoPE#
为 Query 和 Key 设置了单独的旋转矩阵 R。考虑一个二维的情况:
Rmq=(cosmθsinmθ−sinmθcosmθ)(q0q1)
由于内积满足线形叠加性,因此任意偶数维的 RoPE,都可以表示为二维形式的拼接:
Rmcosmθ0sinmθ000⋮00−sinmθ0cosmθ000⋮0000cosmθ1sinmθ1⋮0000−sinmθ1cosmθ1⋮00⋯⋯⋯⋯⋱⋯⋯0000⋮cosmθd/2−1sinmθd/2−10000⋮−sinmθd/2−1cosmθd/2−1q0q1q2q3⋮qd−2qd−1
也就是说,给位置 m 的向量 q 乘上矩阵 Rm、位置 n 的向量 k 乘上矩阵 Rn,并用 变换后的序列做注意力,那么就自动包含相对位置信息了,因为如下恒等式成立:
(Rmq)T(Rnk)=qTRmTRnk=qTRn−mk
由于 Rm 的稀疏性,直接使用矩阵乘法来计算会很浪费算力。因此使用下述方法来实现 RoPE:
q0q1q2q3⋮qd−2qd−1⊗cosmθ0cosmθ0cosmθ1cosmθ1⋮cosmθd/2−1cosmθd/2−1+−q1q0−q3q2⋮−qd−1qd−2⊗sinmθ0sinmθ0sinmθ1sinmθ1⋮sinmθd/2−1sinmθd/2−1
其中 ⊗ 是逐位相乘。在 θi 的选择上,沿用了和 Sinusoidal 位置编码的方案,即 θi=10000−2i/d。
RoPE 不带有显式的远程衰减,通过不同频率的三角函数有效区分了长程和短程。并且直接作用于 Q/K,不改变注意力计算的形式,与 Flash Attention 更为契合,容易 Scale Up。
长度外推优化#
长度外推问题指的是模型在推理阶段无法处理比训练阶段更长的输入的现象(Train Short, Test Long),从而导致模型无法有效捕捉全局信息。
注意力机制理论上可以处理任意长序列,但是 越多的词元去平均注意力就会导致注意力分布越均匀,就不能很好地表征词元之间的关系。
YaRN#
解码策略#
各类解码参数#
- 长度惩罚(Length Penalty) - 将词元概率除以其长度的指数幂 α,缓解束搜索倾向于生成较短的句子;
- 出现惩罚(Presence Penalty) - 将输出词元的 logits 减去惩罚项 α 来降低该词元之后出现的概率;
- 频率惩罚(Frequency Penalty) - 在出现惩罚的基础上给乘法项乘上词元的出现次数。
随机采样的改进策略#
- 温度采样(Temperature Sampling) - 通过调整 logits 的温度系数,从而保证采样过程的随机性,其越小,概率分布越极端,反之越平坦;
- Top-k 采样(Top-k Sampling) - 从概率最高的 k 个词元中进行采样,但是不考虑整体概率分布,无法适应不同的上下文语境;
- Top-p 采样(Top-p Sampling) - 从一个符合特定概率条件的最小词元集合中进行采样,要求其中包含的所有词元的累积概率大于或等于预设阈值 p。
投机采样#
语言模型#
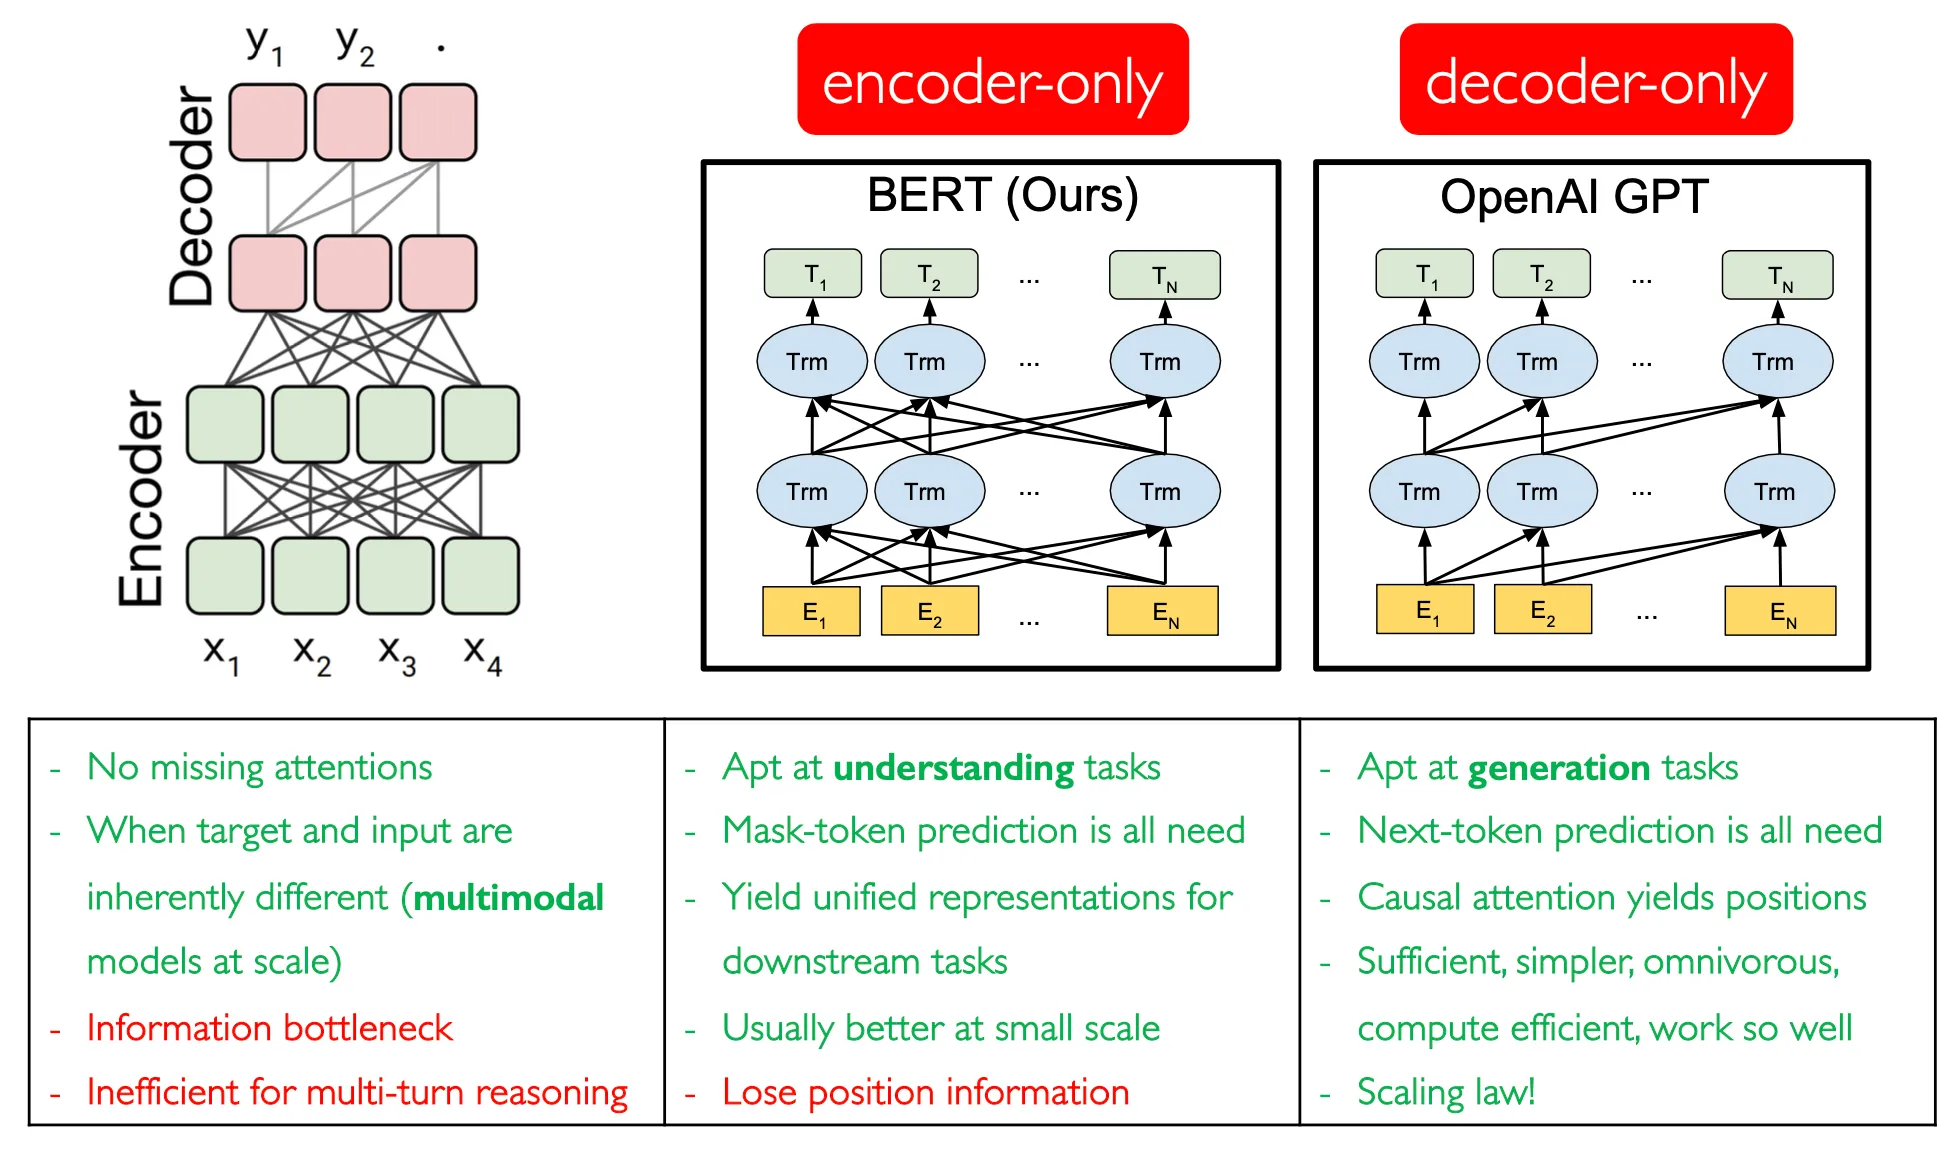
预训练模型确立了 预训练-微调 的范式,即通过大量无标注文本建立模型的基础能力,然后通过有标注数据进行下游任务的微调。
GPT / Decoder#
在大规模语料 u={u1,…,un} 上进行无监督预训练,根据前 k 个词元来预测下一个词元,最大化输出词元的似然:
Lu=∑ilogP(ui∣ui−k,…,ui−1)
然后 取最后一个词元的向量,接一个任务专用的线形层,完成各类任务的微调,并加入预训练的目标函数,避免模型遗忘通用知识:
Ls=∑x,ylogP(y∣x1,…,xm),Lmtl=Ls+λLu
GPT-2 发现通过海量数据训练出来的模型在不做微调的情况下,通过在 Prompt 里加入自然语言指令,就能完成下游任务,即零样本(Zero-Shot)的学习能力。而 GPT-3 发现在 Prompt 中给定少量示例就能让模型适应新任务(In-Context Learning),即少样本(Few-Shot)的学习能力。
BERT / Encoder#
自回归架构的 LM 只能单向建模,而 BERT 通过聚合上下文信息形成 双向建模,从而提高下游任务的能力。
模型的输入嵌入由三个部分构成:词元嵌入、位置嵌入和段嵌入(Segment Embedding)。并且 每个输入序列的首个标记是 [CLS],用作当前句子的表征。用 [SEP] 标记来分割句子,即 [CLS] A [SEP] B。
联合优化两个目标:
- Masked LM(MLM) - 随机遮掩输入中 15% 的子词。但是微调的时候不会出现 [MASK],就会导致训练推理失配问题,可以采用 Scheduled Sampling 解决。即将遮掩词元的 80% 替换为 [MASK]、10% 替换为随机词、10% 保持原词。然后让模型预测遮掩位置的原始词元;
- Next Sentence Prediction(NSP) - 随机从语料库中采样句子对,其中 50% 为相邻句子、50% 为不相邻句子,取 [CLS] 标记的表征输入到分类层中,用来表明输入句子对是否相邻。
后续的改进包括 RoBERTa 去掉了 NSP 任务,引入了 动态遮码 的机制,即每个回合输入句子的 mask 位置都不同,使得模型适应不同的遮码策略,学习不同的表征。还有 ALBERT,将输入嵌入 V x H 转换为两个较小的矩阵 V x E + E x H,从而大幅减少内存消耗和训练速度。
T5 / Encoder-Decoder#
T5 的核心思想是 将所有的 NLP 任务都统一为 “文本-文本” 的格式,并用同一个模型/训练过程/解码方式来完成生成任务。其极大简化了 NLP 的应用流程,研究者们只需关注如何将任务 “表述” 为文本即可。
该模型通过 Span Corruption 的预训练策略来让模型具备通用的文本理解和生成能力,具体来说:1)从文本语料库(C4)中随机抽取句子;2)随机选取连续的文本片段(Spans),并用一个特殊的哨兵标记来替换它们;3)模型的目标就是恢复被破坏的文本片段。其与 BERT 中的 MLM 的区别为 MLM 侧重于局部上下文理解,而 T5 的跨度破坏要求模型不仅要理解上下文,还需要具备生成连贯上下文的能力。
微调阶段给输入文本加上特定任务的前缀即可,比如说 “summarize: [text]“。这种前缀的形式可以看作是指令微调的雏形,其给该模型带来了优秀的泛化能力。
BERT 和 T5 这种遮掩/恢复的自监督范式被称为去噪自编码,“去噪” 指的是给干净文本加入 “噪声”,然后训练模型来恢复原始文本,即 “去噪” 的过程。
架构分析#
视觉模型#
ViT#
ViT ↗ 是 Google 在 2020 年提出的将 Transformer 架构应用在图像分类的模型,其表明了当训练数据较多的时候(14M-300M images),ViT 的表现就会超过 CNN 类模型。
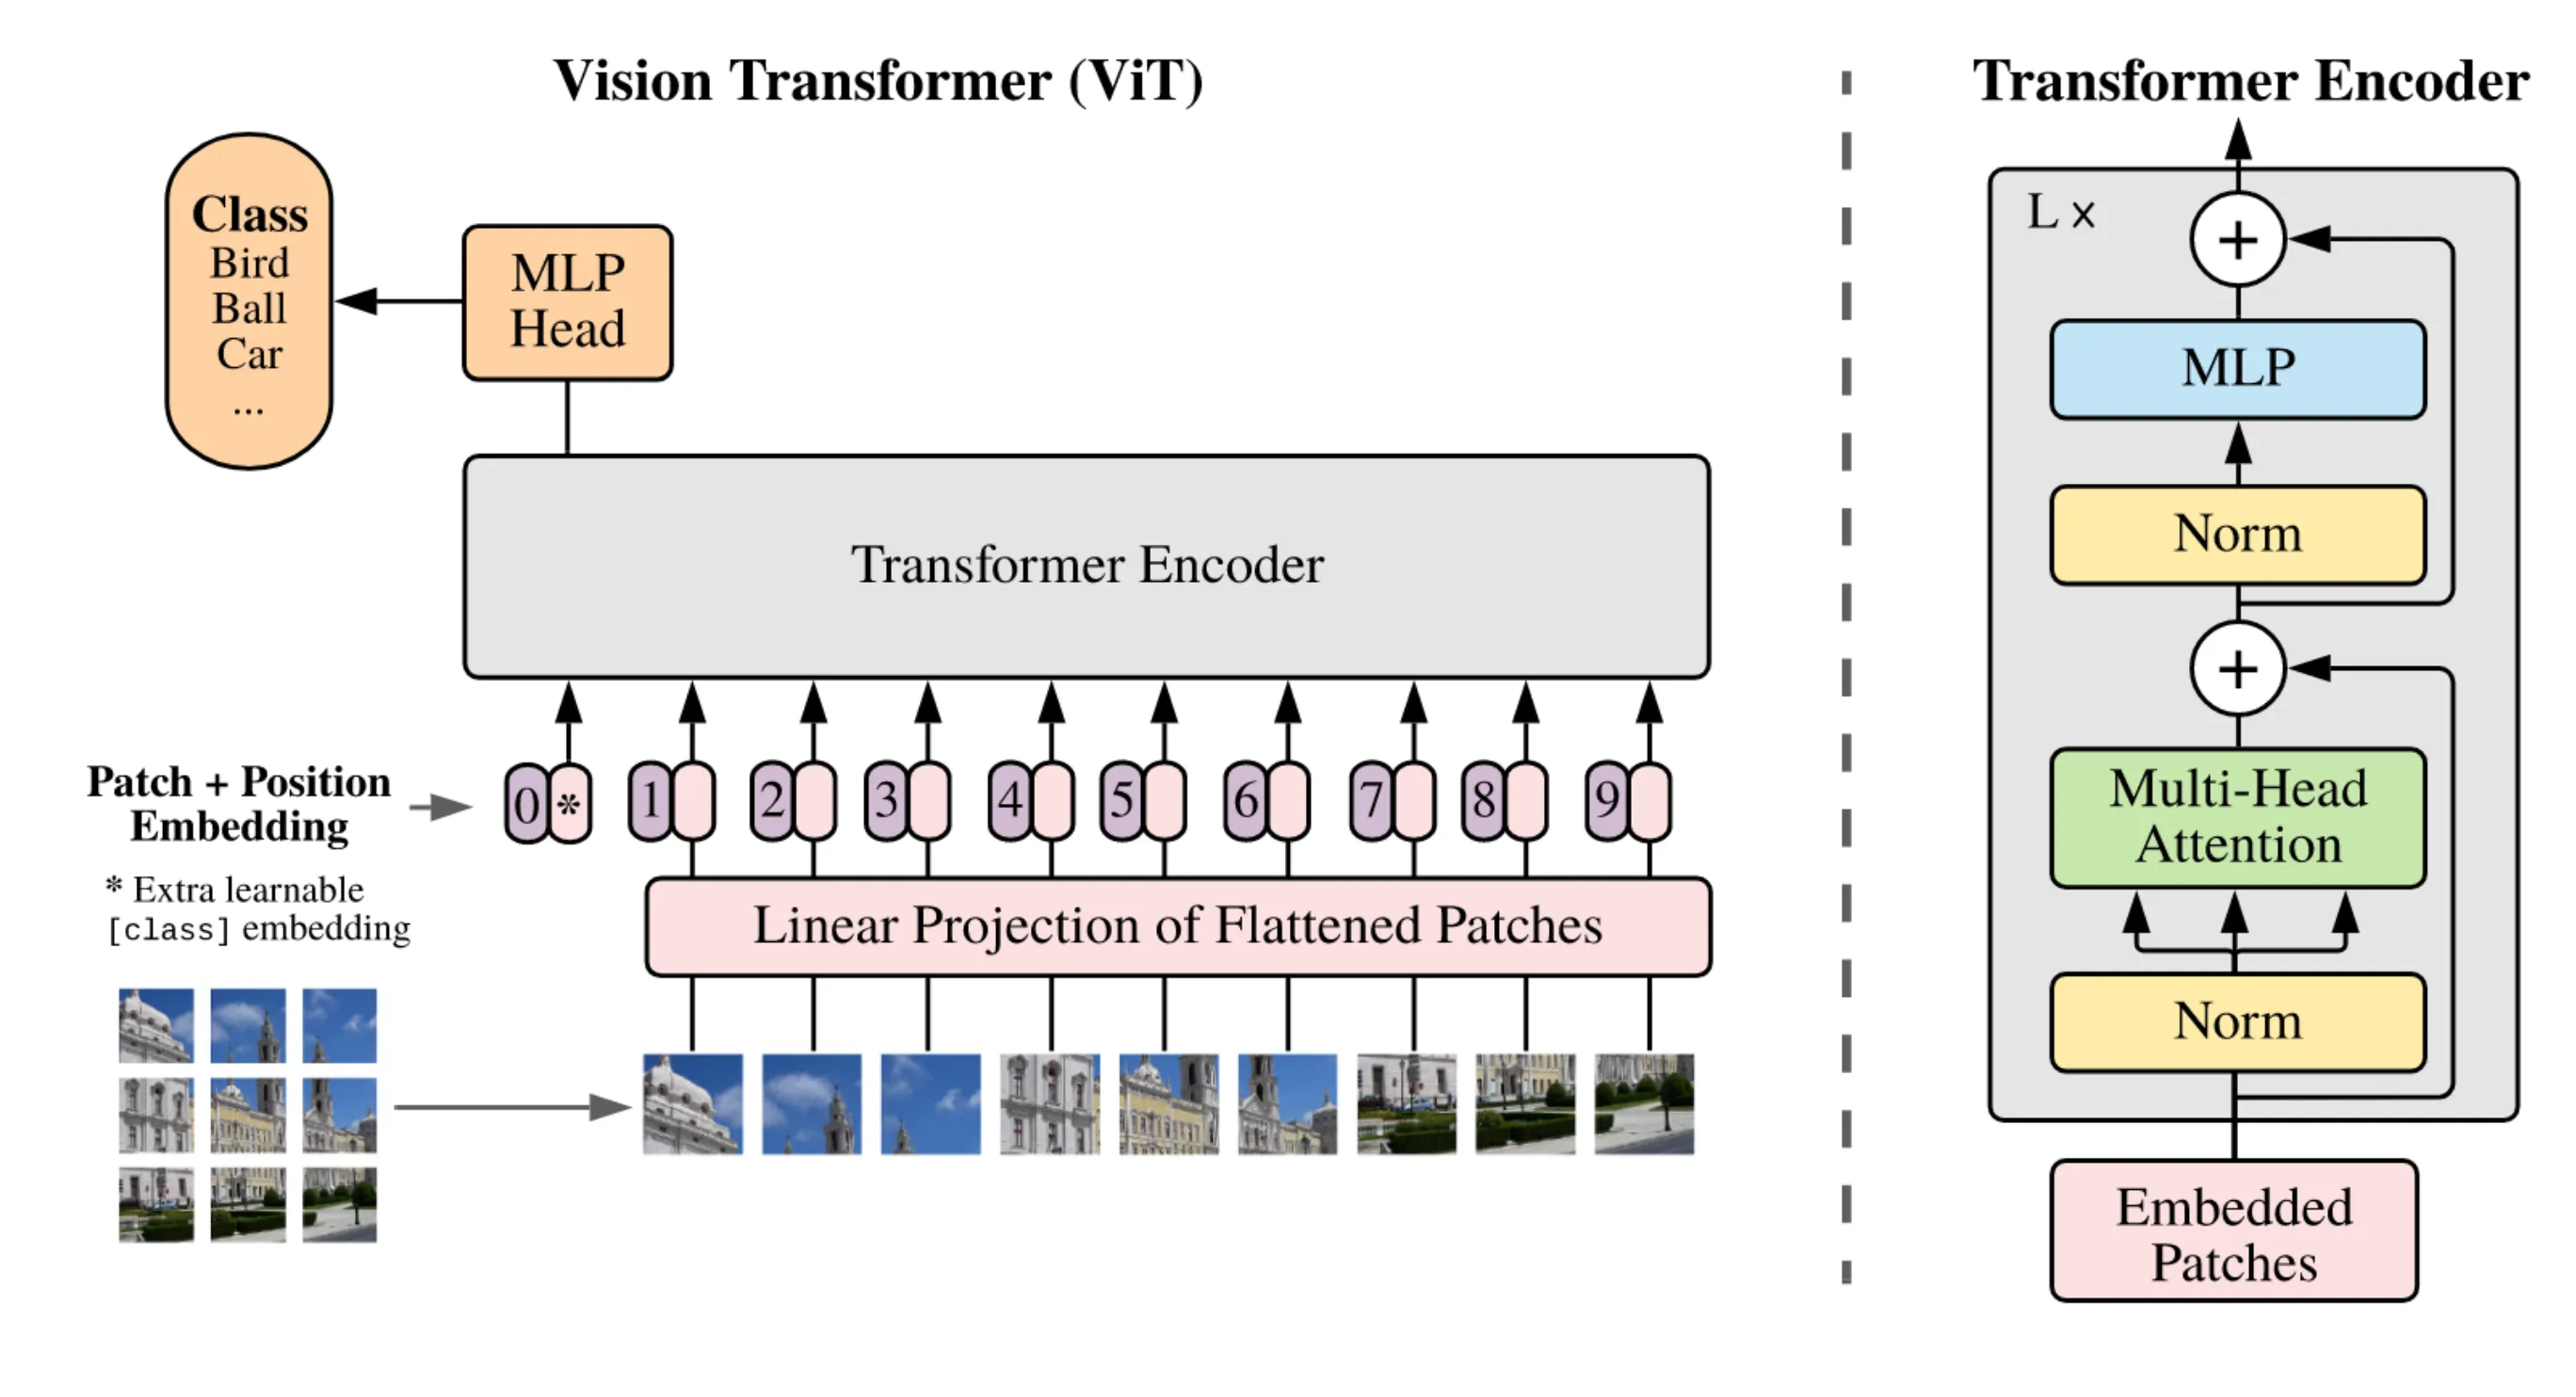
首先将输入图像 [H,W,C] 划分成若干 2D 块然后展平得到 [N,(P2×C)],其中 N 代表块数、P 代表块大小、C 代表通道数。然后添加一个可学习的类别嵌入块,在编码器输出时可作为图像的特征表示。且为了保留图像的位置信息,引入了可学习的 1D 位置编码,直接叠加在嵌入向量上。
以 ViT-L/16 为例,将输入图像 (224, 224) 按 (16, 16) 划分为 (224/16)^2=196 块,每个块展平后变成长度为 16x16x3=768 的一维向量,然后将该一维向量通过线性映射转换为长度为 1024 的块向量,最后添加类别嵌入块向量。最终输入向量大小变化为 (196, 768) -> (196, 1024) -> (197, 1024)。
上述向量化过程称为 Patch Embedding,并且线性映射也可以采用二维卷积来做,即将步长、核大小设置为块大小/16,将输出通道设置为嵌入向量大小/1024。
预训练阶段采用单隐藏层的 MLP 实现,而微调阶段使用单层线性分类器,大小为 D×K,其中 K 表示下游任务类别数量。但是由于微调阶段采用更高分辨率的图片,输入序列的有效长度变长,导致预训练阶段的位置编码不再匹配,因此使用二维插值调整位置编码。
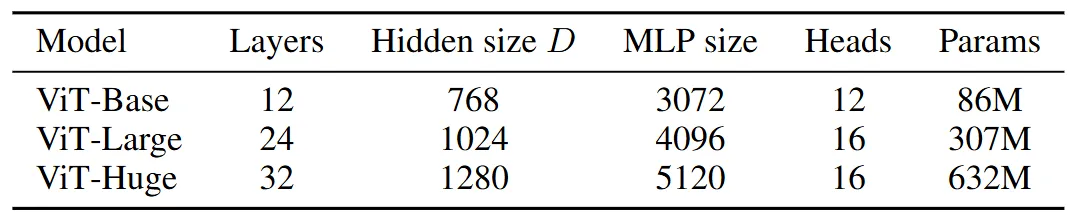
How to train your ViT? Data, Augmentation, and Regularization in Vision Transformers ↗
Swin Transformer ↗ 是 Microsoft 在 2021 年提出的用于充当视觉领域的通用骨干网络,其在 Transformer 的基础上引入了 CNN 的归纳偏置:1)局部性 - 只计算窗口和移动窗口内的注意力,同时跨窗口连接,节省计算量;2)层次化 - 通过分层结构,提取不同尺度的特征,应对视觉实体尺度变化问题。
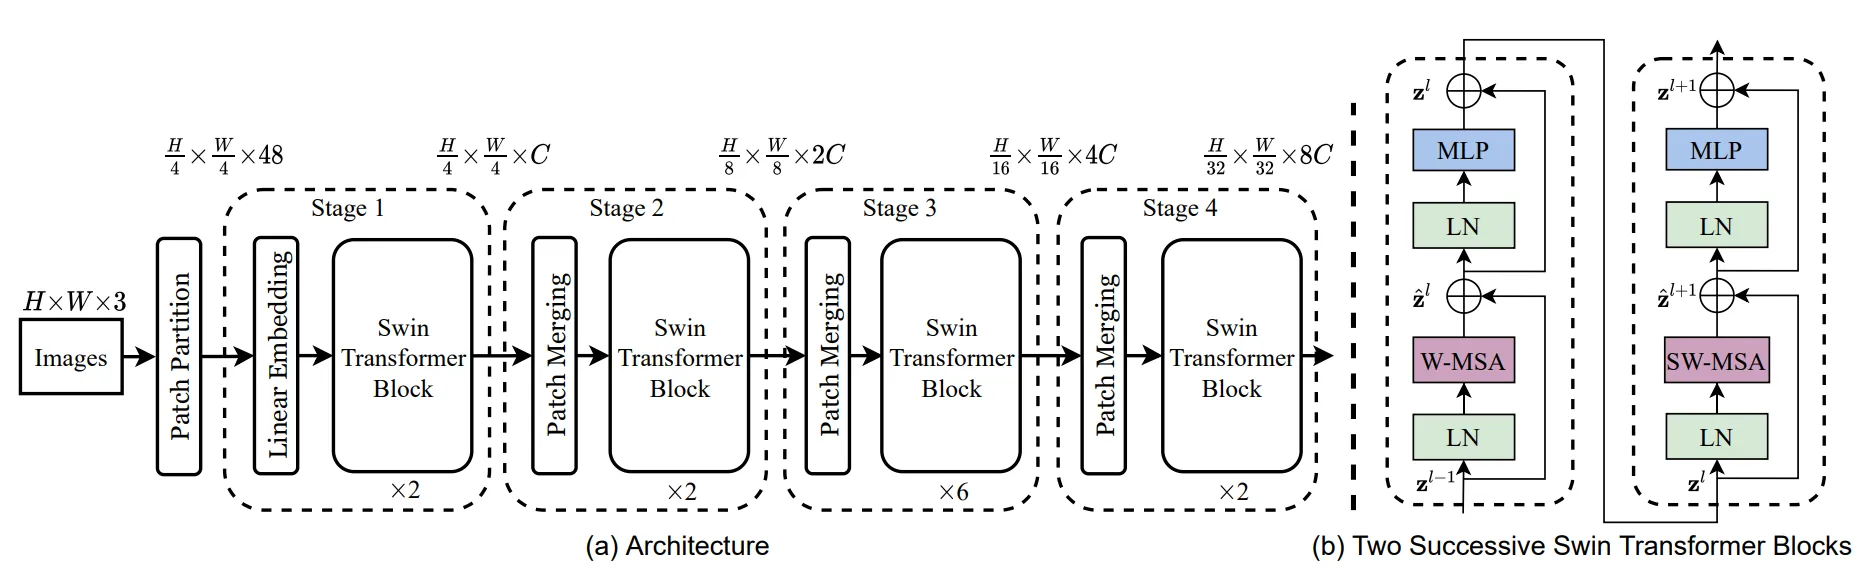
整个模型架构的流程为:
- Patch Partition/Linear Embedding - 将图像分割成不重叠的大小为 4x4 的块,个数为 4H×4W,将每个块的像素值展平得到 48 维的初始特征向量,然后将投影至指定维度 C,此时输入为 4H×4W×C;
- Patch Merging/Swin Transformer Block - 通过 Merge 操作对特征图进行 2 倍的降采样,此时通道维度变为 4 倍,然后通过全连接层调整为 2 倍,逐步形成层次化设计。在进入 W/SW-MSA 之前,首先经过 Window Partition 将特征图划分为多个不重叠的窗口,假设输入特征图大小为 (H,W,C),转换后变为 (wsH×wsW,ws2,C),分别表示总窗口数、窗口内块个数、通道纬度。执行 MSA 计算之后输出特征图大小不变。然后经过 Window Reverse 将特征图大小还原为 (H,W,C)。
由于 W-MSA 只作用在独立窗口内,忽略了窗口之间的联系,因此提出 Shifted Window 划分方法。具体来说,第一个模块采用常规的窗口划分策略,下一个模块在前一个模块的基础上移动 (⌊M/2⌋,⌊M/2⌋) 像素点,M 表示窗口大小。下图左侧就是向右/下移动了两个像素之后形成的划分图。
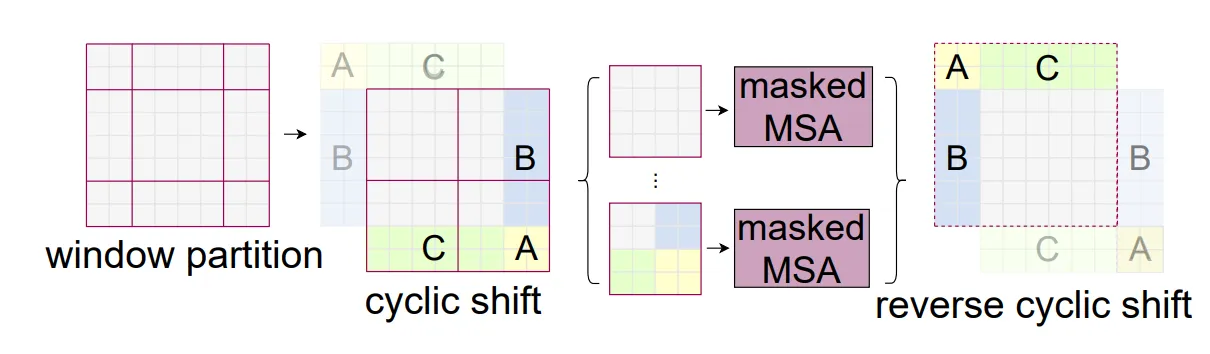
但是该划分方法会导致窗口数量增加以及窗口尺寸不统一,后续进行批处理的时候若通过 Padding 进行填充,则十分低效,因此提出了循环位移(Cyclic Shift)与掩码的方法。具体来说,对原特征图进行左上角的循环位移,再使用掩码机制抑制不相邻块的自注意力计算,从而保持窗口数量和尺寸一致,并确保有效建模。
Image GPT#
Image GPT 是 OpenAI 在 2020 年提出的将 GPT 系列的自回归训练范式运用在图片像素值预测的模型。
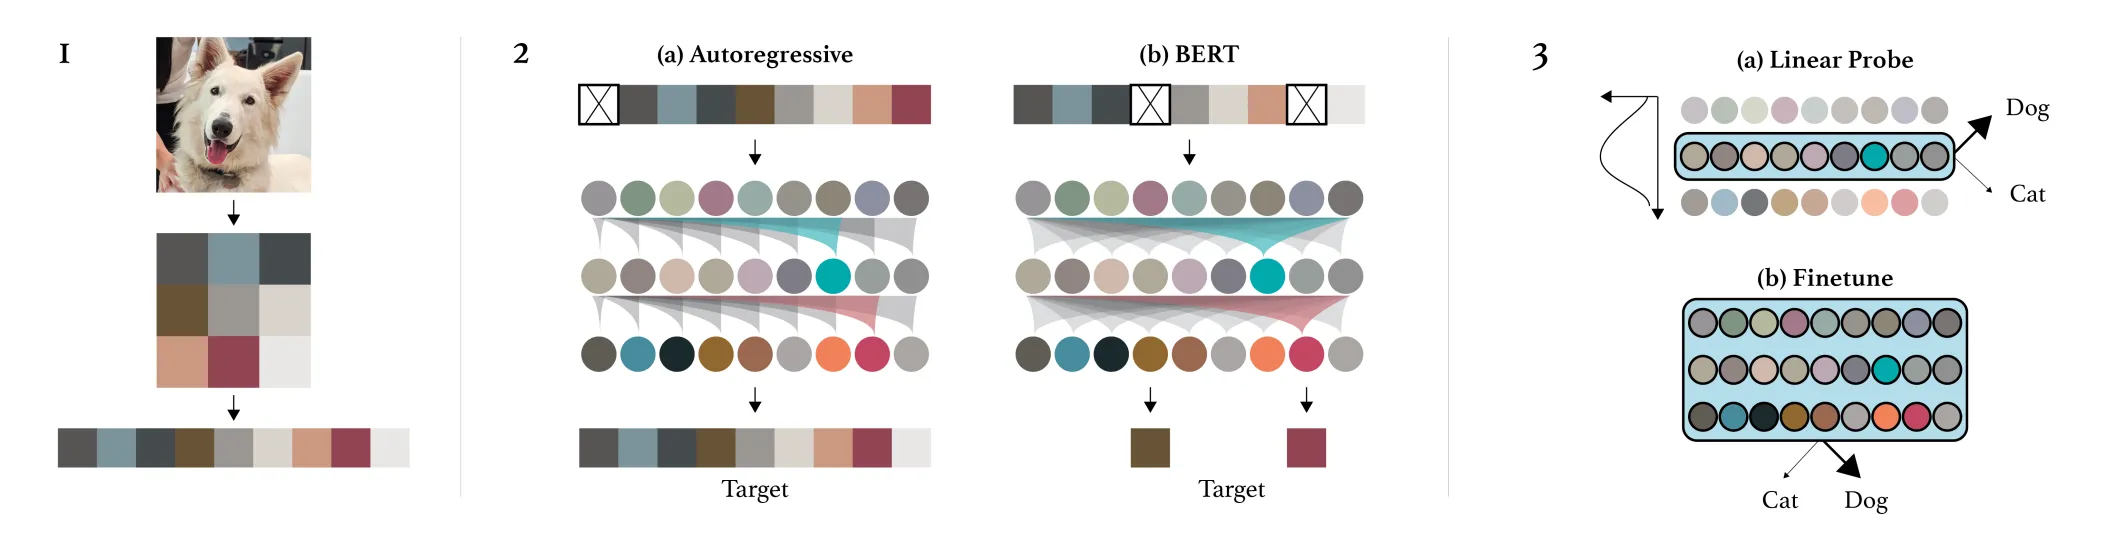
首先将输入图像进行下采样并将其转换为 1D 序列避免原始图像过大导致的注意力计算爆炸。然后使用预训练+微调的范式,采用两种预训练方法:
- Next Pixel Prediction - 该方法根据前面的像素值预测下一个像素值(采用光栅顺序),并最终对图像的概率密度进行整体建模。训练目标是最小化负对数似然:
LAR=Ex∼X[−logp(xπi∣xπ1,xπ2,⋯,xπi−1,θ)]
- Masked Pixel Prediction - 该方法先遮掩输入序列若干位置的值,然后预测遮掩的值。训练目标是最小化遮掩位置元素的负对数似然:
LMASK=Ex∼XEMi∈M∑[−logp(xi∣x[1,n]∖M)]
预训练阶段模型学到了输入序列的表示,有两种来评估后续任务的方法:
- 微调/Fine-tuning - 同时优化 LGEN+LCLF,其中 LGEN 代表 AR 或 MASK 损失、LCLF 代表分类损失。该方法也被称为带有 辅助训练目标 的微调(Fine-tuning with auxiliary training objective);
- 线性探针/Linear Probe - 使用一个线性分类器对冻结参数的模型的内部的某一层特征进行分类的方法。具体来说,对该层特征进行全局平均池化转换为一个特征向量,然后根据该向量来评估下游任务。
Credit#